有时为了保证可用性,需要同时访问两路服务,哪个先返回就取哪个。在 brpc 中,这有多种做法。
在 Channel 中开启 backup request
Channel 开启 backup request 后,会先向其中一个 server 发送请求,如果在 ChannelOptions.backup_request_ms 后还没回来,再向另一个 server 发送。之后哪个先回来就取哪个。在设置了合理的 backup_request_ms 后,大部分时候只会发一个请求,对后端服务只有一倍压力。
以官方示例 backup_request_c++ 为例:client 设定了在 2ms 后发送 backup request,server 在碰到偶数位的请求后会故意睡眠 20ms 以触发 backup request。
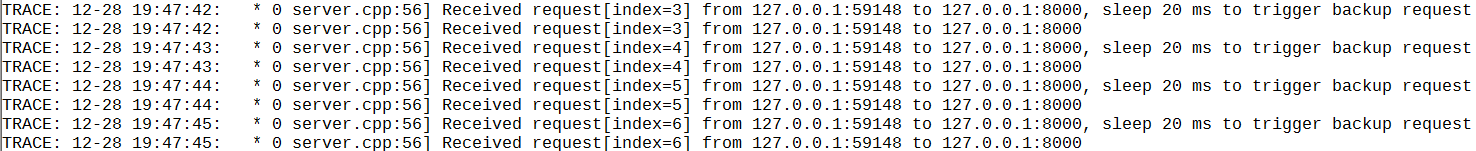
运行后,client 端和 server 端的日志分别如下,“index” 是请求的编号。可以看到 server 端在收到第一个请求后会故意 sleep 20ms,client 端之后发送另一个同样 index 的请求,最终的延时并没有受到故意 sleep 的影响。

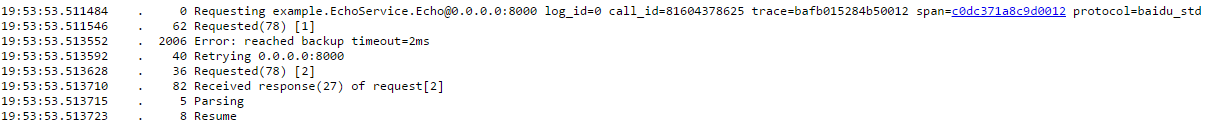
/rpcz 也显示 client 在 2ms 后触发了 backup 超时并发出了第二个请求。
借助 latency_cdf 选择 backup_request_ms
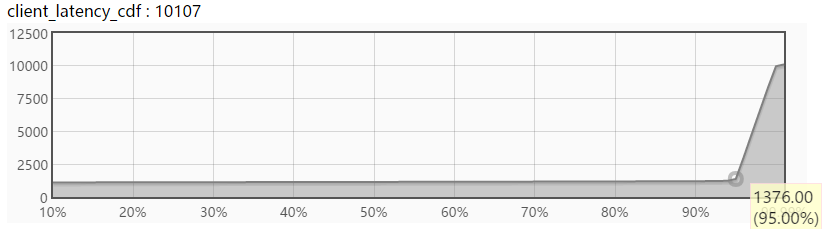
可以观察 brpc 默认提供的 latency_cdf 图,或自行添加。cdf 图的 y 轴是延时(默认微秒),x 轴是小于 y 轴延时的请求的比例。在下图中,选择 backup_request_ms=2ms 可以大约覆盖 95.5% 的请求,选择 backup_request_ms=10ms 则可以覆盖 99.99% 的请求。
自行添加的方法:
#include <bvar/bvar.h>
#include <butil/time.h>
...
bvar::LatencyRecorder my_func_latency("my_func");
...
butil::Timer tm;
tm.start();
my_func();
tm.stop();
my_func_latency << tm.u_elapsed();  // u代表微秒,还有s_elapsed(), m_elapsed(), n_elapsed()分别对应秒,毫秒,纳秒。

// 好了,在/vars中会显示my_func_qps, my_func_latency, my_func_latency_cdf等很多计数器。
SelectiveChannel 方式【推荐】
建立一个开启 backup request 的 SelectiveChannel,其中包含两个 sub channel。访问这个 SelectiveChannel 和上面的情况类似,会先访问一个 sub channel,如果在 ChannelOptions.backup_request_ms 后没返回,再访问另一个 sub channel。如果一个 sub channel 对应一个集群,这个方法就是在两个集群间做互备。SelectiveChannel 的例子可参考官方示例 selective_echo_c++,具体做法请参考上面的过程。
发起两个异步 RPC 后 Join【不推荐】
发起两个异步 RPC 后 Join 它们,它们的 done 内是相互取消的逻辑,官方示例为 cancel_c++。这种方法的问题是总会发两个请求,对后端服务有两倍压力,这个方法怎么算都是不经济的,你应该尽量避免用这个方法。